中美AI,输赢难道取决于短剧?
本文由 降噪NoNoise 撰写/授权提供,转载请注明原出处。
以下文章来源于:降噪NoNoise
作者:刘诗雨
编辑:小维
两年前,知乎上有个话题:为什么说「美国把 AI 用来娱乐,中国把AI用于工业生产」?
彼时,美国的文生视频大模型 Sora 横空出世,其生成的视频几乎以假乱真,在全球范围内引发惊叹与焦虑。而中国的DeepSeek还没出圈,豆包尚未起势,文生视频大模型 Seedance 更是「查无此人」。
两年后,Sora 关停,Seedance、可灵等国产文生视频大模型相继崛起,AI 短剧和视频生成在国内迎来井喷式增长。
围绕中美 AI 用途的争论也出现了戏剧性的反转——
在社交媒体上,「美国用 AI 提升生产力,中国用 AI 拍逆袭短剧」成为一种新的论调,「中国 55%Token 消耗用于短剧」的话题一度登上微博热搜。
更尖锐的言论随之而来,有人借用鲁迅的名言,感叹道:中国人再一次把火药做成了烟花。
看似金句的总结里,是中美 AI 的全部真相吗?
算力到底去哪了
引发这场争论的,是一组悬殊的数据。
10 月 10 日,一则帖子在社交平台传播开来。该帖称,中国 55% 的 Token 消耗用于短剧、短视频、娱乐内容生成,而美国 58% 的 Token 消耗用于编程、研发和企业自动化。
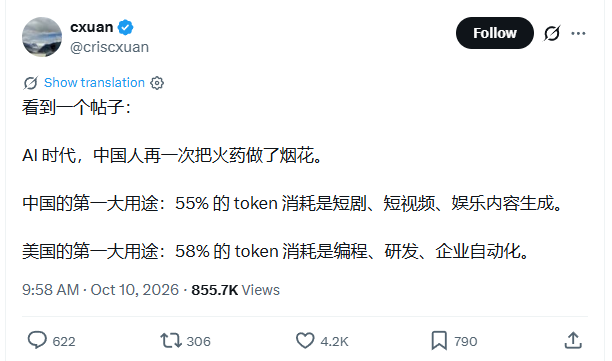
一边忙着生产娱乐内容,另一边忙着编程和研发。鲜明的对比之下,帖主感慨:「AI 时代,中国人再一次把火药做成了烟花。」
此后,相关话题在社交平台上持续发酵。
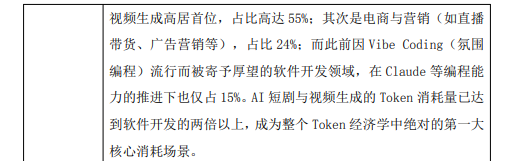
有媒体找到了数据来源,中国的数据出自 A 股上市公司中文在线今年 6 月披露的一份《投资者关系活动记录表》。中文在线称,国内 AI Token 消耗中,短剧与视频生成占 55%,电商与营销占 24%,软件开发占 15%。而帖子中所谓美国 58% 的数据,则被笼统归于「公有 API Token 用量」,未见明确的统计来源。
在一次次转述中,信息也在失真。
「Token 消耗量」被等同于「AI 算力」,「短剧与视频生成」被简化为「爽剧」,「软件开发」也变成了「用于研发」。
几番概念转换后,信息演变成了「中国超过一半的 AI 算力在造爽剧,真正用于研发的只有 15%」,有媒体由此发问:「中国最稀缺的 AI 算力,究竟在造爽剧还是造未来?」
简单来说,Token 消耗衡量的是模型处理和生成了多少信息,而算力消耗衡量的是完成这些工作实际需要多少计算资源。即使处理相同数量的 Token,不同模型由于规模、架构和推理方式不同,所需的计算资源也可能有很大差异。
这就像微信运动中的步数和运动消耗:步数反映走了多少路,但不直接决定消耗了多少热量。同样走一万步,平地散步和爬山的能量消耗可能相差很大。
10 月 19 日,豆包公关负责人刘星公开质疑这组数据不太靠谱。他透露,字节的总算力中,只有约 10% 用于视频生成模型的训练和推理。
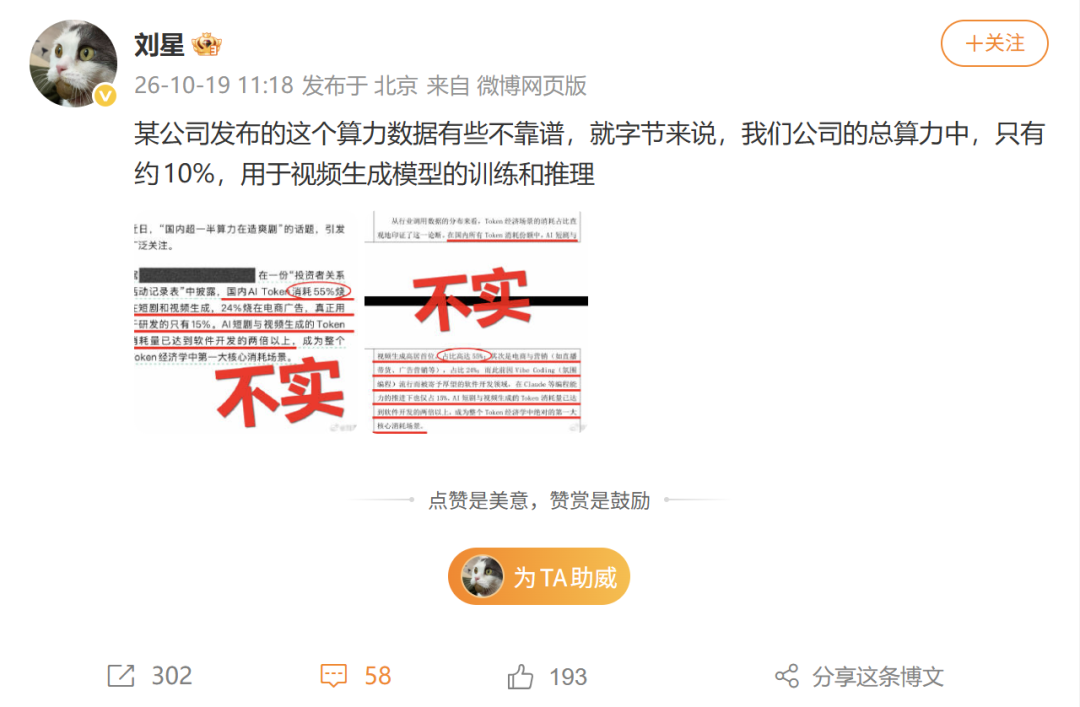
根据《降噪 NoNoise》的求证,引自中文在线的信息本身,同样存在不少疑点。
首先是数据来源难以核实,统计范围也缺乏可比性。
中文在线在《投资者关系活动记录表》中提到,这组数字来自「行业调用数据」,但未进一步披露具体数据来源、统计范围和方法。公开渠道中,也尚未找到能够独立验证这一结论的全国性行业统计数据。
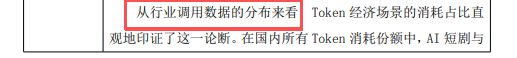
而美国的数据也没有明确的原始出处。
《降噪 NoNoise》查阅发现,去年 12 月,AI 模型 API 聚合平台 OpenRouter 与美国风投机构 a16z 联合发布的《State of AI》报告中,出现了一组相近的数字。
该报告分析了超过 100 万亿大语言模型交互的 Token 使用情况,其中,2025 年末 OpenAI 模型在 OpenRouter 平台上的编程和技术相关 Token 消耗各占 29%,合计恰好为 58%。
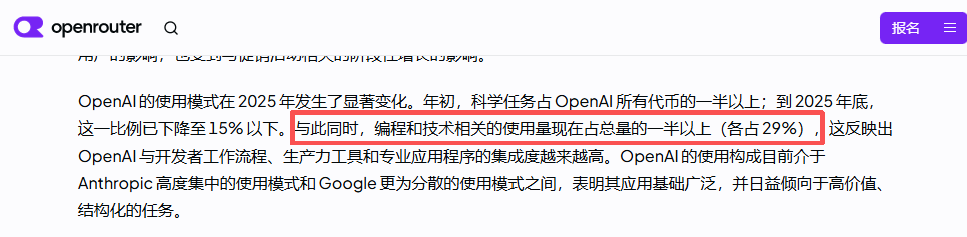
不过,这一数据仅是 OpenRouter 平台的 OpenAI 模型使用情况,并非美国整体的 AI 使用情况。而且,报告只统计大语言模型,并不包含文生视频模型的消耗,这与中文在线所称的视频生成数据并不在同一统计范围内。
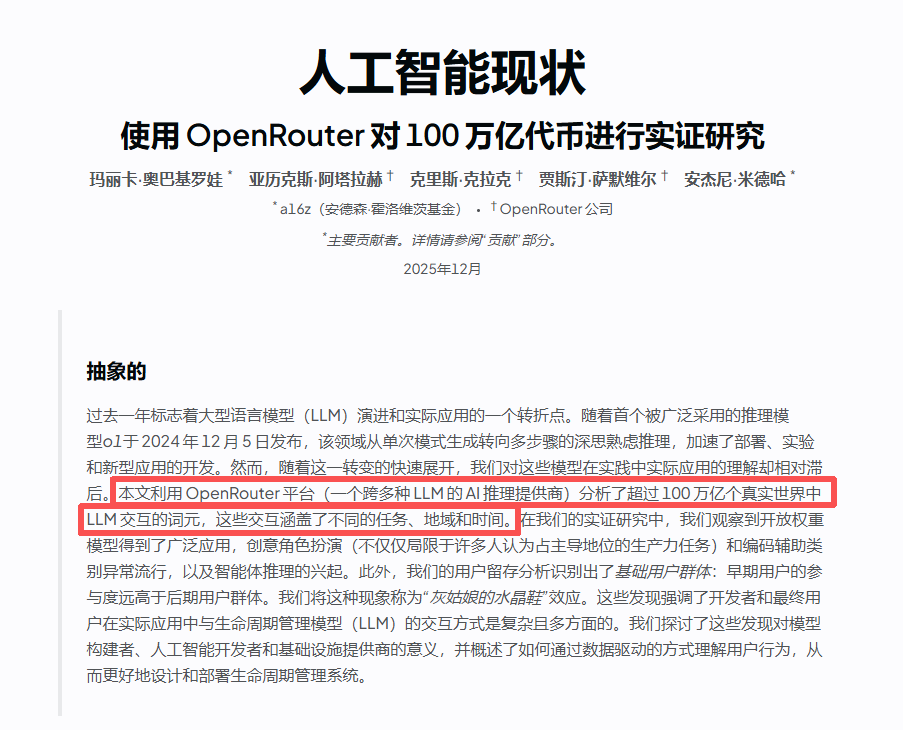
截至目前,我们尚未发现一份按统一标准比较中美 AI 应用场景的 Token 消耗统计。
其次,模型来自哪个国家,也不代表 Token 就消耗在哪个国家。中国用户可能使用 ChatGPT、Claude 等海外模型,美国用户也可能使用 DeepSeek、Seedance 等中国模型。
这点从中国 AI 公司的收入结构可窥见一二,目前 MiniMax 超 60% 的收入来自海外,可灵AI约70%的收入来自海外。
除此之外,AI 的使用还分散在 API 调用、个人订阅、企业内部部署等不同渠道,第三方机构很难完整掌握这些数据。
再者,文本与视频 Token 虽然名称相同,计量方式却并不一致。甚至在某些实际应用中,语言模型尤其是多轮交互的 Agent,累计处理的 Token 数量可能比一次视频生成任务更多。
因此,将两类 Token 简单加总,再据此判断不同 AI 应用的使用情况,容易产生误导。
既然如此,为何一个未经证实的中美 AI 用途对比,能让这么多人相信?
被标签化的中美 AI
传播学中的例证理论认为,人们在判断复杂问题时,容易受到具体、生动案例的影响,进而用少数例子推断整体情况。
一段 AI 短剧可以在社交媒体上迅速传播,一个 AI 智能体将某项商业工作大幅降本增效未必会成为热门话题,所以认知偏差更易形成——大众舆论场容易把传播声量当成产业实力,把最显眼的应用当成最重要的应用。
今年以来,中美 AI 市场恰好都出现了足够醒目的案例。
在中国,红果短剧日均使用时长超过抖音和微信,逼得腾讯重新押注短剧抢夺用户注意力。随着 Seedance 等视频生成模型能力提升,AI 漫剧大量涌现,千篇一律的「AI 脸」让观众触发「恐怖谷效应」,模板化台词「不烧心」成了网络热梗。
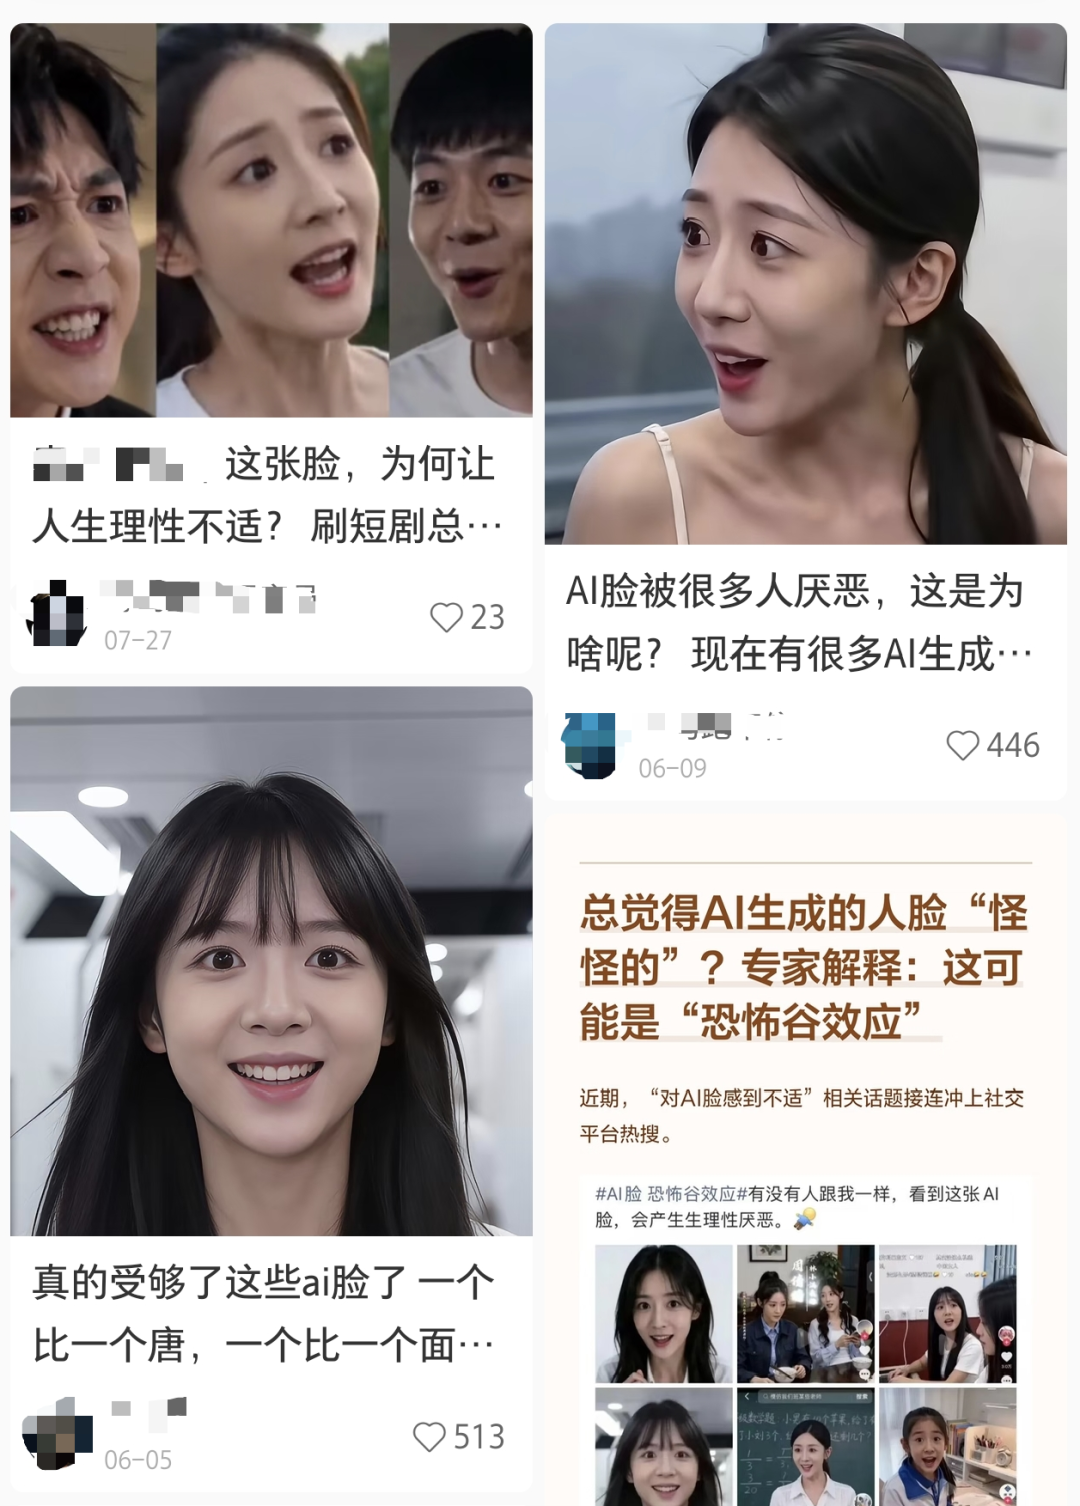
社交媒体上网友们对千篇一律的「AI 脸」感到不适
在美国,OpenAI 关停轰动一时的 Sora,将更多资源转向编程和企业服务,并与 Anthropic 展开角逐。Sora 被关,不是因为它不够好,恰恰是因为其能力出色、太烧钱,眼睁睁看着 Claude 的编程能力带动 Anthropic 的 ARR(年度经常性收入)一路飙升,OpenAI 自然是要有所取舍的。
在企业服务市场,中美之间的差异也被一线创业者感知到。
一位常年在中美两地从事企业 AI 业务的创业者告诉《降噪 NoNoise》,相比中国,美国企业客户的付费意愿更强,AI 服务也更容易形成生意。
而这些热度也有相应的数据佐证——OpenAI 和 Anthropic 的企业业务收入分别占 40% 和 80%,微软的 Microsoft 365 Copilot 的付费席位不断上涨,美国软件公司 Palantir 仰仗 AI 机遇成为 AI 商业化第一股……
中美 AI 眼下跑出来的生意,都有各自的产业土壤。
在中国,短视频、短剧、电商营销等行业早已形成庞大的内容生产需求,也因此诞生了成熟的内容工业和流量分发体系,短视频平台、短剧平台和直播电商的商业化机制相当完善,视频生成模型的出现,只不过是恰好切入了这些行业降本增效的需求。
我们近期接触过的短剧从业者多数由真人短剧转向 AI 短剧,电商商家们也在通过 AI 批量制作、修改营销素材,降低成本、缩短制作周期。快手财报显示,今年第二季度,平台 AIGC 短视频营销素材的投放消耗同比增长超过 70%。
换句话说,AI 短剧的盛行某种程度上是中国既有互联网产业能力的一种延伸,更是这条产业链发展的必然,但并非中国 AI 能力的全部体现。
美国的企业 AI 的商业化,同样是建立在一套成熟体系之上。
微软等公司早已培养起企业按年订阅、按席位采购软件的付费习惯,也建立了成熟的客户渠道。AI 到来后,微软将 Copilot 嵌入 Office 办公体系,Palantir 将 AI 接入企业原有的数据和业务系统,Anthropic 则通过企业订阅和 API 服务向企业客户输出 AI 能力。
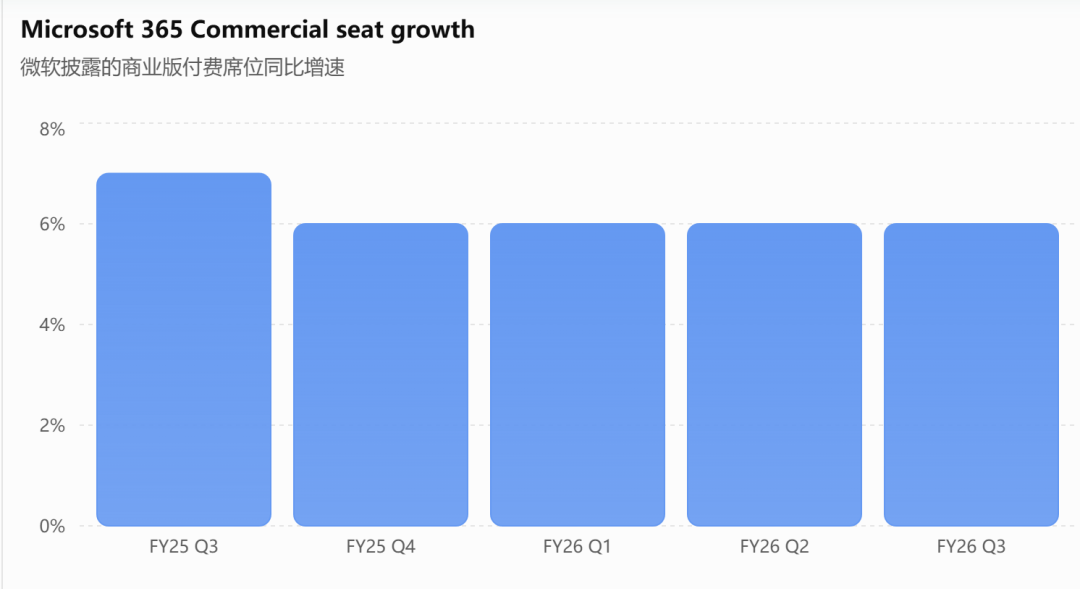
Microsoft 365 商业版付费席位
已经连续多个季度保持在 6% 以上的增速
但差异之内亦有交集。全球来看,AI 视频生成都不是一门冷清的生意。据彭博社报道,今年 9 月,美国 AI 视频公司 Runway 的 ARR 已经达到 2 亿美元,五个月内翻了一倍。包括杜嘉班纳在内的品牌,正将其技术用于广告和营销制作。
短剧也并非中国市场的独有偏好,字节旗下海外短剧应用 PineDrama 上线不到一年,全球累计下载量便突破 1 亿次。
AI 短剧不是原罪,娱乐本身也不是原罪。真正值得追问的是,当 AI 把内容生产成本降低到前所未有的水平时,这种效率提升最终会流向哪里?
如果它让更多独立创作者拥有表达能力,让小团队也能制作过去无法承担的作品,那么 AI 确实扩大了创作的边界。
但如果它主要被用于批量生产更符合算法偏好的内容,以更低的成本争夺更多的用户时间,那么技术带来的生产力提升,就可能转化为更高效率的注意力竞争。
视频模型的用途也远不止于此。 Seedance 已被用于制作多语言产品介绍、企业培训等视频内容,一些企业还在探索利用视频生成技术合成机器人训练数据、模拟自动驾驶中的极端场景。
只是,相较于复杂的商业化结构,人们显然更容易记住几个鲜明的标签。
路径差异还是目标分裂?
波士顿咨询公司(BCG)今年 6 月发布的一份研究指出,美国凭借资本、人才和算力优势,持续投入前沿模型研发;中国则更加重视低成本模型的普及,以及 AI 向实体经济的扩散。
零一万物联合创始人、AI 连续创业者祁瑞峰在接受《降噪 NoNoise》采访时引入了「Cost Play&Value Play」的概念,即中国偏向通过低成本、规模化应用获取收入;而美国偏向通过高价值场景获取收入。这也解释了为什么两国会出现不同的 AI 应用形态,以及为什么相同的模型能力可能走向不同的商业化路径。
当然两国 AI 商业化的侧重点也是一个动态变化的过程。
中国 AI 也在编程和企业服务市场加速追赶。今年以来,智谱 GLM-5 系列、Kimi K3 等国产模型的编程和复杂任务处理能力接连取得突破,10 月 24 日,月之暗面正式发布 Kimi K3.1 Pro,并当即冲上 Artificial Analysis 全球智能指数第四名,超过了 GPT-6 Astra。
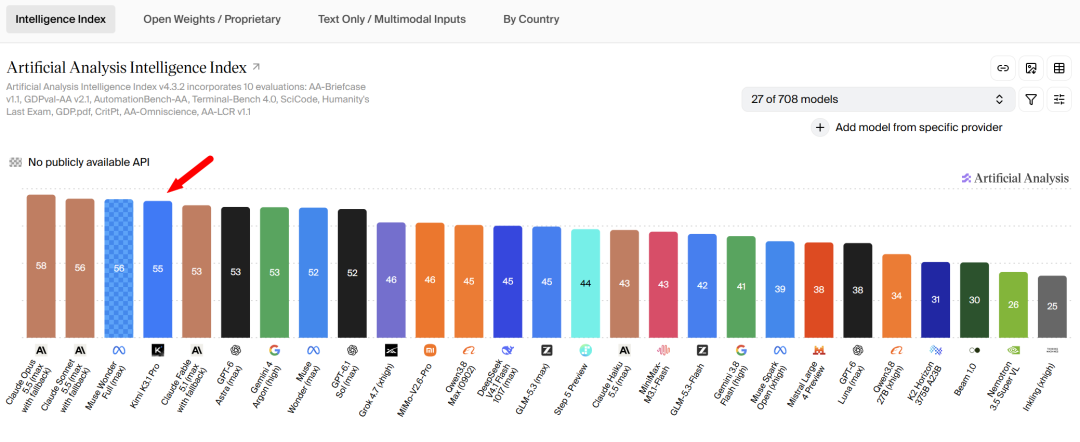
截至 10 月 25 日,Kimi K3.1 Pro 排名第四
技术进步也在同步转化为收入。今年上半年,MiniMax 开放平台及其他AI企业服务收入达到 7390 万美元,同比增长 703.1%,占总收入的 63.4%;同期,智谱开放平台及 API 业务收入达到 8.25 亿元,同比增长 2735.7%,成为公司主要的收入来源。
大厂也在争抢企业 AI 市场。腾讯、字节、阿里纷纷推动企业 Agent 接入办公生态,并招聘 FDE (前线部署工程师),加速 AI 在企业落地。
所以,中美 AI 眼下的商业化差异,真的会演变成长期技术发展目标上的分裂吗?
祁瑞峰表示,「从模型到应用」与「从应用到模型」这样两种技术创新机制已经显现——美国的技术突破可能先提高模型能力,再催生新的工具和应用;中国则可能因为短剧、视频生成等已有的变现场景,反过来推动模型能力提升。
AI 的发展远未定型。可以确定的是,在这一过程中,大众对中美 AI 的看法,会随着热门产品的变化而摇摆,也难免受到科技竞争叙事和不同价值判断的影响。
如果市场能够为高频、低成本的内容生成付费,企业就可以通过规模化应用寻找商业回报;如果市场愿意为编程、科研或企业自动化支付更高价格,企业就可以通过高价值服务获得收入。这些路径并不必然代表不同的技术理想,而可能是不同市场条件下,对同一个现实约束的回应。
真正值得比较的,不是谁今天用 AI 赚到了哪一类钱,而是谁能通过可持续的商业模式,持续投入研发、积累应用反馈,并不断突破模型能力的边界。如果两国头部公司追求的长期目标高度重叠,那么商业化路径的差异,首先应该被理解为抵达目标的不同策略,而不是目标本身已经分裂的证据。
当然,这种正向循环并非必然发生。商业化可能反哺技术突破,也可能让企业长期停留在容易变现的局部优化中。因此,中美 AI 的长期差异,最终还需要回到基础模型能力、研发机制和实际技术进展上验证。
扫一扫 在手机阅读、分享本文

扫码关注公众号
获取更多技术资讯
{{ val.activity_name }}

免费领取技术福利
发送名片申请入群
Netflix马上交卷:AI是降低内容成本,还是又一个烧钱项目?
2026-10-19
Meta如何打造Muse:200人,一场七个月的「押注」
2026-10-19
国产AI日韩剧走红,头部爆款变现数百万
2026-10-20
“豆包手机”们,拼到朋友圈了
2026-10-21
AI短剧“杀不死”游戏
2026-10-20
AI模拟「推特」,年入千万美元
2026-10-21
不被“办公”整合,腾讯Marvis走出硬件“管家”之路
2026-10-21
Optimus量产在即!特斯拉又要封神了?
2026-10-22